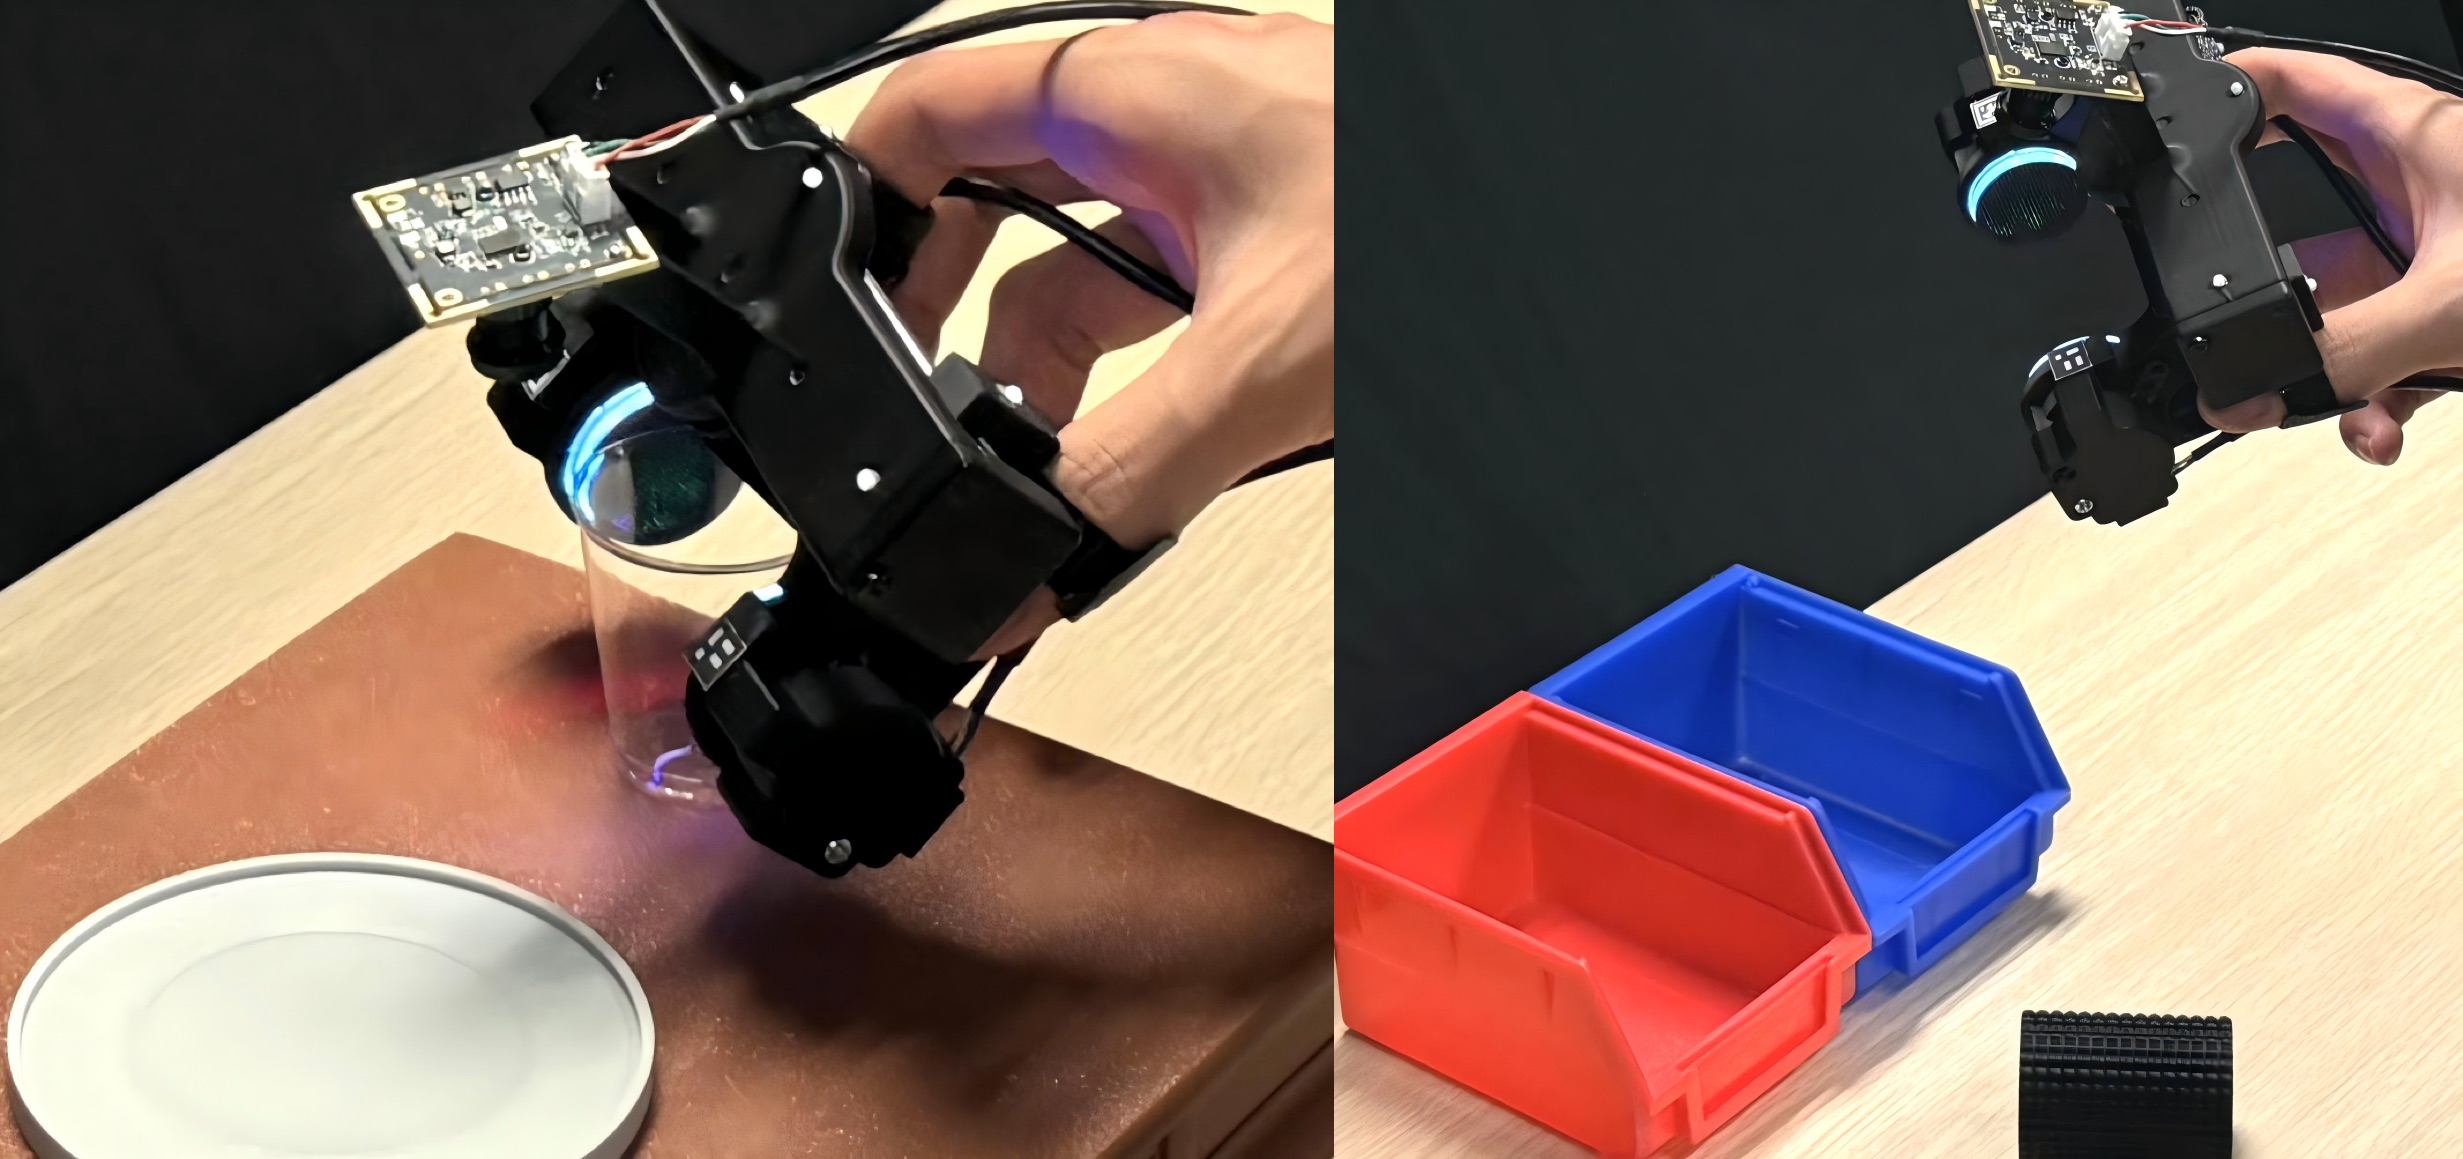
图:FreeTacMan 相关实验装置与操作场景
机器人要完成易碎杯抓取、USB 插接、书写、盖章等复杂接触操作,难点不只是“看见物体”,还要理解接触发生在何处、夹爪如何移动、动作轨迹如何变化。香港大学、上海创智学院李弘扬团队在 ICRA 2026 发表论文《FreeTacMan: Robot-free Visuo-Tactile Data Collection System for Contact-rich Manipulation》,提出一种在数据采集阶段无需机器人本体参与的视觉-触觉数据采集系统 FreeTacMan。该研究中,NOKOV度量动作捕捉系统跟踪 FreeTacMan 采集接口,并在夹爪工具中心点处确定末端执行器的高精度 6D 位姿;研究团队将位姿数据与视觉、触觉和夹爪开口宽度同步记录,为机器人复杂接触操作策略学习提供多模态数据基础。
在机器人学习中,抓取、插接、装配、书写这类任务通常涉及连续接触、微小位姿变化和力控调整。仅依靠视觉图像,机器人可以看到目标物体,却不一定知道夹爪是否已经接触物体、接触状态如何变化,以及人类操作者在每一步如何调整姿态。
因此,复杂接触操作的多模态示范轨迹通常需要包含多类信息:视觉数据用于记录环境和物体状态,触觉数据用于记录接触反馈,6D 位姿用于描述夹爪末端执行器的位置和姿态,夹爪开口宽度用于记录开合状态。在 FreeTacMan 中,这四类数据流被同步记录,用于机器人策略学习。
围绕机器人复杂接触操作,常见数据采集方式包括机器人本体采集、遥操作、AR/VR 采集以及手持式采集。它们各有优势,但在大规模、多任务、强接触反馈场景中仍存在限制。
采集方式 | 主要特点 | 主要限制或处理要求 |
机器人本体采集 | 直接在机器人上安装传感器采集操作数据 | 受机器人配置限制,采集规模和任务多样性较难扩展 |
遥操作 / AR / VR | 可记录相机视角、控制指令或运动轨迹 | 标定复杂,可能存在延迟,直接触觉反馈不足 |
SLAM / IMU 手持采集 | 灵活度较高,适合手持设备采集 | 容易产生漂移或跟踪误差,影响位姿数据精度 |
FreeTacMan+NOKOV度量动作捕捉系统 | 操作者直接完成示范;视觉、触觉、6D 位姿和夹爪开口宽度组成多模态轨迹 | 动作捕捉数据需降采样后与腕部RGB图像同步;位姿需经坐标转换和逆运动学处理,最终与视觉、触觉和夹爪开口宽度共同组成用于机器人策略学习的多模态轨迹。 |
针对这些限制,研究团队提出 FreeTacMan,改变了传统依赖机器人本体的数据采集方式,并设计了配备视觉-触觉传感器的可穿戴抓取装置,使操作者能够直接感受夹爪与物体之间的接触。其完整的数据采集方式如下。
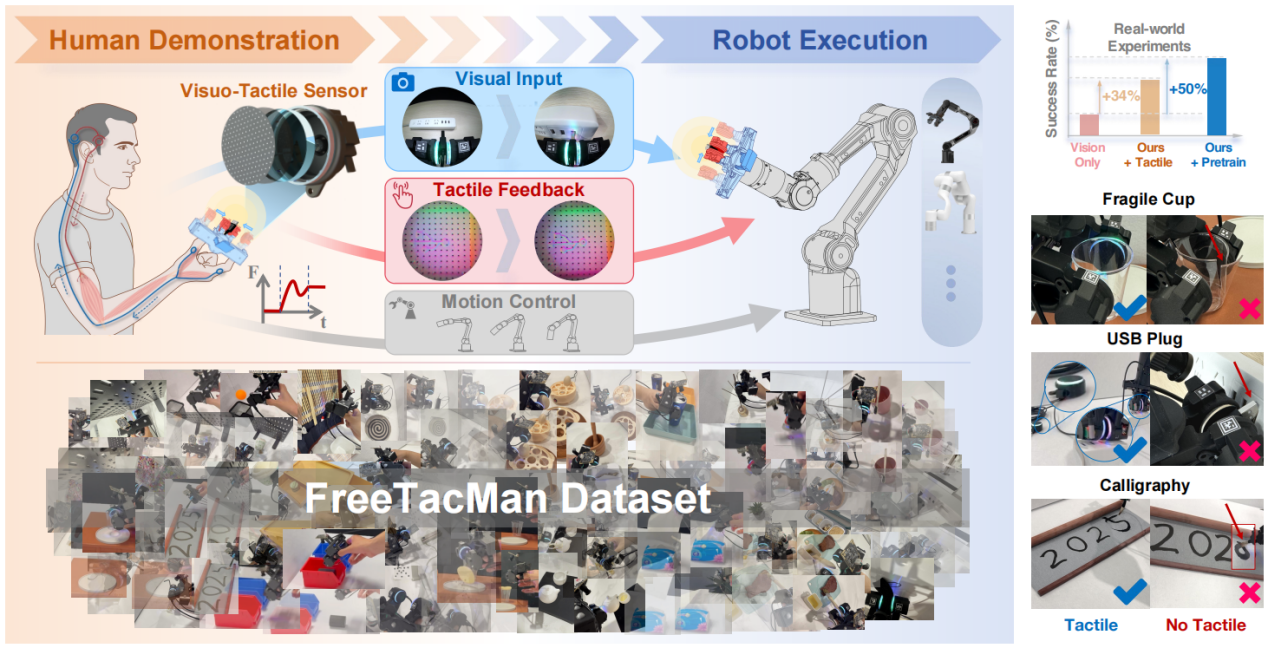
FreeTacMan 概览。 FreeTacMan 是一种无需机器人参与、以人为中心的视觉-触觉数据采集系统,能够将人类的视觉、触觉和运动技能高效迁移到机器人上,并支持大规模多接触操作数据集的采集。
一种方式是让操作者使用 FreeTacMan 采集接口中的视觉-触觉夹爪完成示范,无需机器人本体参与数据采集。研究团队同步记录腕部 RGB 图像、两张视觉-触觉图像、夹爪末端执行器的 6D 位姿和夹爪开口宽度,形成用于机器人模仿学习的多模态示范轨迹。FreeTacMan 还包含执行接口,这些轨迹可用于训练机器人策略,使机器人完成相似操作。
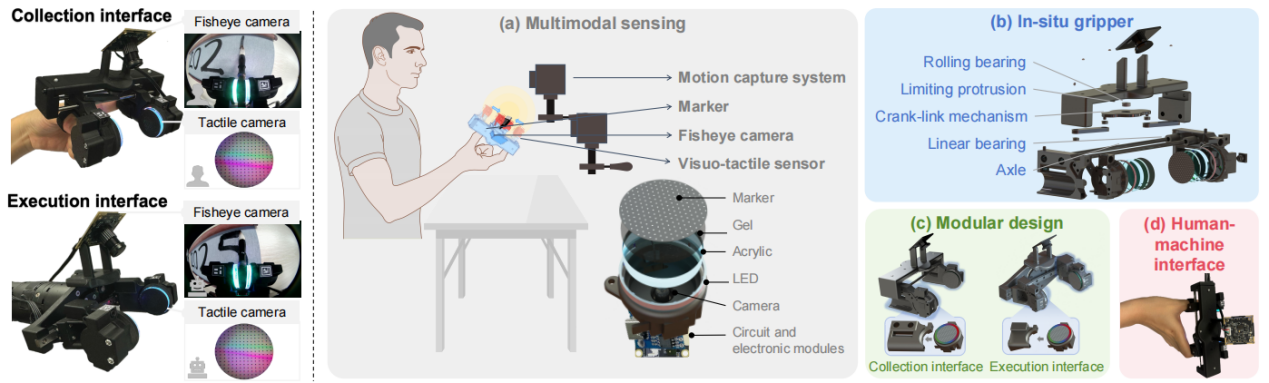
硬件系统设计。 左侧分别展示了采集接口和执行接口中的原位夹爪,两者具有相同的视觉和触觉观测。右侧展示了:(a) 传感器组成;(b) FreeTacMan 结构分解图;(c) 模块化设计支持采集接口与执行接口之间快速切换;(d) 人机接口设计。
这种设计的核心价值在于:数据采集阶段无需在机器人本体上直接采集,而是由人类操作者在真实接触场景中完成示范,再将示范过程记录为可用于策略训练的多模态轨迹。
在 FreeTacMan 中,NOKOV度量动作捕捉系统跟踪采集接口,并确定夹爪末端执行器的 6D 位姿;研究团队将位姿数据与腕部 RGB 图像、两张视觉-触觉图像和夹爪开口宽度同步记录,形成多模态示范轨迹。位姿数据再经过坐标转换和逆运动学处理,成为策略学习的动作表征。
数据类型 | 来源 | 在机器人学习中的作用 |
RGB 图像 | 相机观测 | 记录环境、物体位置和操作过程 |
视觉-触觉图像 | 夹爪触觉传感器 | 记录接触形变、接触状态和表面信息 |
夹爪开口宽度 | FreeTacMan 夹爪 | 描述抓取过程中的开合变化 |
6D 位姿 | NOKOV 度量动作捕捉系统 | 记录采集接口中夹爪末端执行器的位置、姿态和运动轨迹 |
动作捕捉负责为FreeTacMan多模态轨迹提供末端执行器位姿数据。具体采集时,NOKOV度量动作捕捉系统以240 Hz频率跟踪采集接口,并在夹爪工具中心点处确定末端执行器的6D位姿,达到亚毫米级精度。采集接口上共安装 5 个反光标记点:3 个位于顶部板,用于测量整体位姿;2 个位于夹爪上,用于捕捉相对位移。研究团队随后将跟踪数据降采样后与腕部 RGB 图像同步。
6D 位姿用于把操作者通过采集接口完成的示范映射为机器人动作。研究团队将标记点坐标从世界坐标系转换至机器人基座坐标系,建立与机器人 URDF 模型坐标轴对齐的局部坐标系,并使用 IKPy 逆运动学求解器将夹爪末端执行器的位姿直接映射为机器人关节位置,作为策略学习的动作表征。相比依赖 SLAM 或 IMU 的手持定位方式,光学动作捕捉可避免 IMU 漂移和相关跟踪误差,为需要高精度轨迹的数据集构建提供位姿测量来源。
基于 FreeTacMan,研究团队构建了一个大规模、高精度视觉-触觉操作数据集。该数据集覆盖 50 类多接触操作任务,包含 1 万余条操作轨迹和 300 万余组视觉-触觉图像对。实验任务包括易碎杯抓取、书法、纹理分类、盖章和 USB 插接,分别验证力控、力-位置混合控制、触觉感知和动态响应等能力。
在数据采集对比实验中,FreeTacMan 在完成率、采集效率和综合 CPUT 得分上均优于 ALOHA 和 UMI。其中,CPUT 得分是遥操作方法的 5.05 倍,是 UMI 的 1.52 倍。
在模仿学习实验中,研究团队将视觉-触觉数据用于 ACT 策略模型训练。结果显示,仅使用视觉输入时,ACT 平均成功率为 21%;加入触觉后提升到 55%;进一步加入触觉预训练后提升到 71%。这说明,在复杂接触任务中,触觉和高质量多模态轨迹能为机器人策略学习提供更充分的训练信息。
实验指标 | 结果 |
数据集规模 | 50 类任务,1 万余条轨迹,300 万余组视觉-触觉图像对 |
采集效率对比 | CPUT 得分为遥操作方法的 5.05 倍,为 UMI 的 1.52 倍 |
ACT 仅视觉输入 | 平均成功率 21% |
ACT 加入触觉输入 | 平均成功率 55% |
ACT 加入触觉预训练 | 平均成功率 71% |
FreeTacMan 案例展示了一条面向复杂接触操作的数据采集路径:由人类操作者完成操作示范,通过视觉-触觉夹爪记录接触信息,再利用 NOKOV度量动作捕捉系统确定夹爪末端执行器的高精度 6D 位姿,最终形成可用于机器人模仿学习的多模态轨迹。
对于正在开展机器人抓取、插接、装配、触觉感知和模仿学习研究的团队来说,实验系统需要同时解决“看得见”“感知得到”“轨迹可量化”“数据可同步”四个问题。NOKOV度量动作捕捉系统在其中提供夹爪末端执行器的高精度 6D 位姿数据,使研究团队能够将视觉、触觉、6D位姿和夹爪开口宽度数据组织为时间对应的多模态轨迹,用于机器人训练数据构建。
在FreeTacMan中,每帧示范数据包括一张腕部RGB图像、两张视觉—触觉图像、末端执行器6D位姿和夹爪开口宽度。这些数据经同步后组成用于机器人策略学习多模态示范轨迹,分别记录操作场景、接触状态、末端执行器的位置与姿态以及夹爪开合状态。
FreeTacMan允许操作者直接使用手持采集接口完成操作示范,无需控制机器人本体执行采集任务。论文的数据采集对比实验显示,其CPUT分别达到ALOHA和UMI的5.05倍和1.52倍,为提高复杂接触操作示范数据的采集效率提供了一种具体方法。
触觉数据可以补充视觉信息难以完整反映的接触状态。在 FreeTacMan 的模仿学习实验中,ACT策略的平均成功率从仅使用视觉时的21%提高到加入触觉后的55%,进一步采用触觉预训练后达到71%。
 北京市朝阳区安慧里四区15号五矿大厦8层820室
 info@nokov.com
 010-64922321